
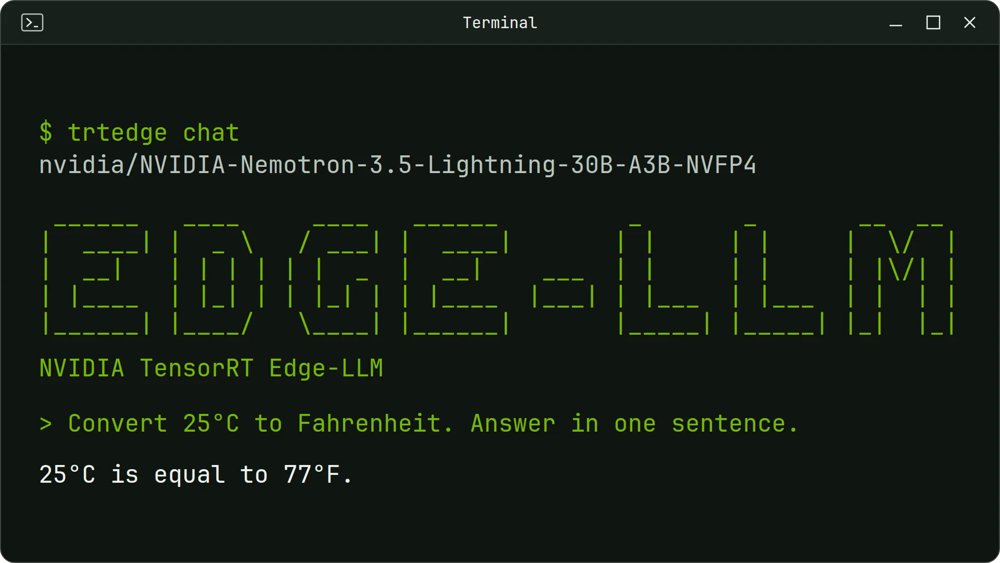
NVIDIA 30 октября опубликовала рабочий сценарий запуска Nemotron-3.5 Lightning на DGX Spark 64GB через TensorRT Edge-LLM. Модель можно использовать в терминале и подключать к локальным приложениям через API.
Общий путь от прототипа к встроенному устройству
TensorRT Edge-LLM представляет собой облегчённую среду выполнения на C++, предназначенную для задач ИИ на периферийных устройствах. NVIDIA предлагает использовать DGX Spark для подготовки и проверки моделей, а затем работать с тем же семейством средств на Jetson Thor, DRIVE AGX Thor и IGX Thor. В центре анонса находится упрощение разработки приложений, которым важно учитывать память, энергопотребление и задержку ответа.
Командный интерфейс trtedge берёт на себя загрузку выбранной модели и создание оптимизированных TensorRT-движков. В опубликованном примере используется текстовая Nemotron-3.5 Lightning. После подготовки можно вести диалог прямо в терминале либо поднять локальный сервер с API, совместимым с форматом OpenAI. Такой интерфейс позволяет подключить модель к прототипу приложения без обязательной отправки запросов в облачный сервис.
Конфигурация и измерения NVIDIA
Пример проверен производителем с TensorRT Edge-LLM 0.11.1 и TensorRT 10.16.1.11. Указаны CUDA 13 и Python 3.10–3.12; для TensorRT требуется совместимая версия ветки 10.x. Первая загрузка модели занимает около 21 ГБ, причём дополнительное место необходимо для собранных движков. Поэтому речь идёт о конкретной поддерживаемой конфигурации, а не об универсальной установке на любой компьютер с видеокартой.
Для ускорения генерации NVIDIA использует DSpark: небольшая черновая модель предлагает несколько токенов, которые проверяет основная. В опубликованном измерении на запросах HumanEval средняя скорость выросла с 73,4 до 126,9 токена в секунду при трёх черновых токенах. Эти цифры получены самим производителем для заданных условий; их нельзя считать независимым тестом или гарантией такой скорости на другой нагрузке.
Что означает пример для разработчика
NVIDIA раскрывает важные условия замера: один одновременно обрабатываемый запрос, пакет размером один, ограничение ответа в 128 токенов и формат NVFP4. Пиковое использование системной памяти с DSpark составило 27,9 ГБ вместе с операционной системой. Такие детали помогают сопоставлять результат со своим прототипом: при большем контексте или нескольких клиентах потребление ресурсов и задержки могут измениться.
Практическая ценность публикации — в связке локального диалога, сервера и повторно используемых движков. Разработчик получает способ проверить поведение модели до интеграции в более сложное устройство. Для перехода к эксплуатации всё равно потребуются собственные измерения, проверка совместимости целевой платформы и контроль доступа к серверу. Редакция запуск на DGX Spark не выполняла; приведены условия и результаты официального примера.
Источники
- Официальный анонс — 2026-10-30